

유전체 분석의 ‘난공불락’ D4Z4 Repeat, Long-read와 전용 분석 툴로 뚫어내다!
Sookjin Lee
Chief Business Officer (CBO) | 생명과학 박사
정밀의료·유전체 분야에서 20년간 혁신을 이끌어온 비즈니스 전문가. 학술적 전문성과 시장 통찰력을 바탕으로 혁신 기술의 상업화와 가치 창출을 가속화합니다.
핵심 요약
- D4Z4 Repeat 분석 한계 극복: 4번/10번 염색체의 99% 유사성과 거대한 반복 구조 때문에 기존 Short-read 기술로는 FSHD 진단에 한계가 있었습니다.
- Long-read + 전용 툴(Kivvi) 도입: PacBio Long-read 데이터와 Kivvi 분석 툴을 빠르게 도입·개선하여 반복 수 카운팅과 염색체 출처 분리를 성공적으로 구현했습니다.
- 실제 임상 진단 입증: 단순 기술 검증을 넘어 실제 희귀질환(FSHD) 환자 6명을 성공적으로 진단하며 높은 임상적 가치를 입증했습니다.
유전체 분석 기술이 눈부시게 발전했지만, 인간 유전체(Genome)에는 여전히 분석이 극도로 까다로운 ‘블랙박스’ 영역들이 존재합니다.
대표적인 곳이 바로 D4Z4 Repeat(반복 서열) 영역인데요. 최근 쓰리빌리언은 Long-read 데이터와 최신 전용 분석툴을 신속히 도입해, 실제 환자 샘플 진단까지 성공적으로 마쳤습니다.
오늘 포스팅에서는 D4Z4 분석이 왜 그토록 어려웠는지, 그리고 저희 팀이 이 난관을 어떻게 극복해냈는지 비하인드 스토리를 전해드립니다.
1. D4Z4 Repeat 영역과 질환 진단
D4Z4 Repeat는 인간의 4번 염색체(4q35) 끝에 위치한 약 3.3 kb 크기의 반복 서열 단위(Unit)입니다.
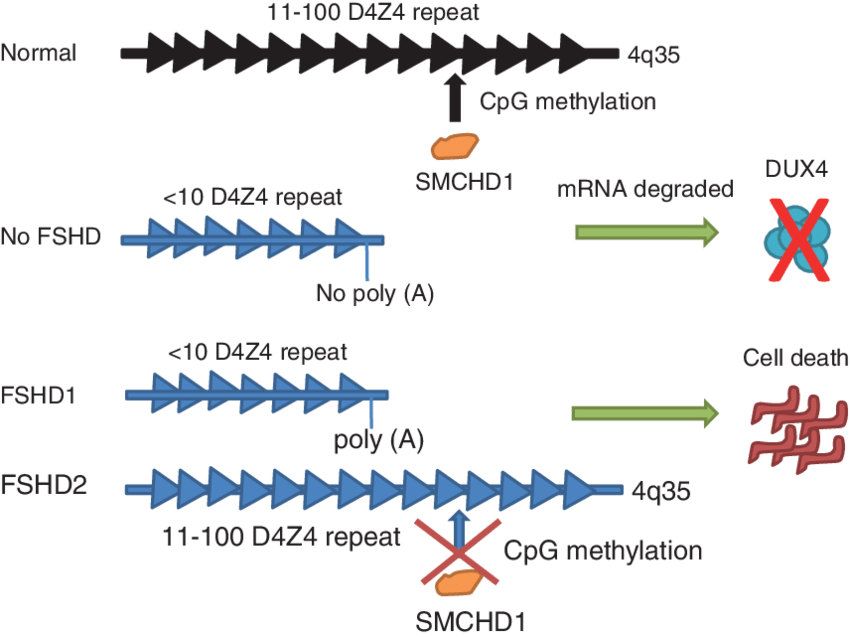
- 정상인: D4Z4 유닛이 11~100개 이상 길게 반복됨
- 안면견갑상팔 근디스트로피(FSHD) 환자: 반복 수가 1~10개로 감소(Contraction)함
즉, D4Z4 유닛이 몇 개나 반복되어 있는지를 정확히 정밀 측정하는 것이 FSHD 진단의 핵심 기준이 됩니다.
2. D4Z4 분석, 왜 이렇게 어려울까?
이론상으로는 단순해 보이지만, D4Z4 영역은 유전체 분석가들에게 가장 까다로운 구간입니다. 복잡한 유전적·후성유전적 조건을 동시에 풀어내야 하기 때문입니다.
- 수십 번 반복되는 거대한 구조: 3.3 kb 단위가 수십 개씩 연결되어 있어, 기존 Short-read처럼 짧게 끊어 읽는 기술로는 전체 반복개수를 정확히 셀 수 없습니다.
- 4번 vs 10번 염색체의 ‘99% 유사성’: 10번 염색체(10q26)에도 4번 염색체(4q35)와 99% 이상 동일한 D4Z4 서열이 존재합니다. 읽어낸 데이터가 진짜 4번 염색체에서 온 것인지 정확히 가려내는 기술이 필수적입니다.
- 하플로타입(4qA vs 4qB) 구분: D4Z4 개수가 10개 미만으로 줄어들더라도, 말단에 Poly(A) signal이 존재하는 4qA 구조(Permissive)여야만 질환이 발병합니다. Poly(A) signal이 없는 4qB 구조는 발병하지 않으므로, Repeat 개수와 하플로타입을 동시에 식별해야 합니다.
- 후성유전학적 메틸화(Methylation) 상태: Repeat 개수가 정상(11~100개)이더라도, 메틸화 억제가 풀려버리면(탈메틸화) FSHD2라는 형태의 질환이 발생합니다. 따라서 CpG 메틸화 수준까지 함께 측정해야 완벽한 진단이 가능합니다.
💡 요약하자면:
D4Z4 분석은 ① 4번/10번 염색체 구분 + ② D4Z4 Repeat 개수 산출 + ③ 4qA/4qB 하플로타입 결정 + ④ CpG 메틸화 분석이라는 4가지 고난도 미션을 한 번에 풀어야 하는 복합 과제입니다.
3. 기존 진단 방식(Southern Blot)의 한계
D4Z4 분석의 기존 표준 방식은 서던 블롯(Southern Blotting)이었습니다. 하지만 임상 현장에서 여러 한계가 존재했습니다.
- 숙련도 종속성: 검사자의 숙련도에 따라 결과 해석 차이가 크고 에러율이 존재함
- 위험 물질 사용: 방사성 동위원소 및 위험 화학물질을 사용해 검사 환경 구축이 까다롭고 위험함
- 긴 소요 시간: 결과를 얻기까지 수일에서 수주일 이상 소요됨
결국 기존 방식은 자동화·디지털화된 최근 검사 흐름에 맞지 않는 노동집약적 방식이라는 한계가 명확했습니다. 뿐만 아니라 하플로타입과 메틸화 분석까지 별도로 이루어져야 해서 많은 실험이 필요합니다.
4. 대안으로 떠오른 Long-read Sequencing
수천~수만 베이스쌍(bp)을 한 번에 읽어내는 Long-read Sequencing(PacBio, Oxford Nanopore 등)의 등장으로 D4Z4 분석의 새로운 길이 열렸습니다.
긴 서열을 통째로 읽어냄으로써 반복 구조 전체를 아우를 수 있게 되면서, 이론적으로는 Long-read 장비만 돌리면 D4Z4 진단 문제가 완전히 해결될 것처럼 보였습니다.
5. “데이터 생산만 한다고 끝이 아닙니다”
하지만 현장의 실상은 달랐습니다. 장비에서 데이터(Raw Read)가 나온다고 해서 곧바로 완벽한 진단 결과가 도출되는 것은 아니기 때문입니다.
- 에러율 보정: Long-read 특유의 높은 에러율(Error rate)을 정밀하게 보정하지 못하면 반복 수를 잘못 카운팅하기 쉽습니다.
- 노이즈 필터링: 99% 동일한 10번 염색체 서열을 완벽히 걸러내는 전용 매핑 알고리즘이 필수적입니다.
저희 팀은 단순히 시퀀싱 데이터를 생산하는 데 그치지 않고, D4Z4 전용 최신 분석 툴을 빠르게 도입해 실제 데이터에 적용했습니다. 이를 통해 정확한 Repeat 개수와 하플로타입을 동시에 판별하며 실제 임상 진단 프로세스까지 완벽히 입증해냈습니다.
“Long-read를 다룰 수 있다”는 것과 “Long-read로 D4Z4를 정확히 분석해 진단할 수 있다”는 것은 완전히 다른 차원의 이야기입니다.
6. 개발팀 미니 인터뷰
D4Z4 파이프라인 도입과 실제 진단 성공을 이끈 개발팀의 이야기를 직접 들어보았습니다.
Q. D4Z4 파이프라인을 구축하면서 가장 힘들었던 점은 무엇이었나요?
김성윤 연구원 (생물정보학자):
“역시 4번 염색체와 10번 염색체를 정밀하게 분리하는 작업이었습니다. 서열이 99% 이상 같아서 단순 반복 서열만 봐서는 출처를 구분할 수 없거든요.
그래서 저희가 도입한 PacBio의 Kivvi 툴은 반복 영역 바깥의 양쪽 측면(Flanking) 서열을 Haplotype 단위로 분리해 역으로 출처를 추적하는 방식을 사용합니다. 실제 데이터에 적용해보니 조립된 Allele 대부분에 염색체 출처를 부여할 수 있었습니다. 다만 툴이 내놓는 반복 수 결과에 4번과 10번이 섞여 나열되는 특성이 있어, 리포팅 시 각 염색체별로 반복 수를 명확히 구분할 수 있도록 파이프라인을 정돈했습니다.”
Q. 분석 툴 도입을 넘어 ‘실제 진단’까지 성공했다는 것은 어떤 의미인가요?
류승우 박사 (임상유전학자):
“FSHD는 희귀질환 중 유병률이 비교적 높지만, 발병 기전이 일반적인 단일유전자 질환과 달라 진단이 매우 까다롭습니다. 기존 Short-read 기술로는 한계가 명확해 분석 불가를 안내할 수밖에 없어 안타까웠던 영역이기도 합니다.
그러나 Long-read 검사와 최신 분석 기술(Kivvi)을 빠르게 도입하면서 D4Z4 반복 서열의 명확한 해석이 가능해졌고, 최근 실제 환자 6명을 성공적으로 진단해냈습니다. 이는 복잡했던 FSHD 진단 과정을 단 하나의 통합 유전체 검사로 단순화하여, 진단 소요 시간과 비용을 획기적으로 줄이고 희귀질환 진단의 접근성을 높인 의미 있는 성과입니다.”
Q. 앞으로의 목표가 궁금합니다.
류승우 박사 (임상유전학자):
“D4Z4를 시작으로, 그동안 기존 NGS 기술로는 다루지 못했던 난공불락의 반복 서열 유전질환(SCA, Fragile X syndrome 등) 분석 파이프라인을 지속 확장해나갈 계획입니다. Long-read의 잠재력을 진짜 임상 가치로 전환하는 최전선에 서겠습니다.”
💡 마치며
이론에 그치지 않고 현장의 문제(Pain point)를 분석 툴과 실증 데이터로 풀어내는 것, 이것이 바로 저희가 추구하는 유전체 분석의 혁신입니다.
D4Z4 분석 및 Long-read 서비스에 대해 더 궁금한 점이 있으시다면 언제든 문의해 주세요!
쓰리빌리언 유전자 검사가 궁금하신가요?
영업일 기준 1일 내 답변드립니다.