

[판독노트 #3] 왜 IGV read count와 GATK AD 값이 다를까?
Medical Genetics Group
3billion
환자 유전체 분석을 통해 희귀질환 원인 변이를 발굴하고 임상적 해석 및 연구 역량 강화에 기여합니다.
차세대염기서열분석(Next-Generation Sequencing, NGS)을 통해 검출된 변이를 검토할 때, 연구자와 임상 유전체 분석가는 Variant Call Format(VCF)에 기록된 변이 정보와 Integrative Genomics Viewer(IGV)에서 관찰되는 sequencing read를 함께 확인합니다.
이 과정에서 IGV에서 직접 확인한 REF 및 ALT read의 개수가 VCF에 기록된 Allelic Depth(AD) 값과 일치하지 않는 경우가 있습니다. 예를 들어, IGV에서는 ALT allele을 지지하는 read가 25개로 관찰되지만 GATK HaplotypeCaller가 생성한 VCF에서는 ALT AD가 18로 기록될 수 있습니다.
이러한 차이가 반드시 variant calling 오류나 데이터 손상을 의미하는 것은 아닙니다. IGV와 GATK HaplotypeCaller는 read를 평가하고 집계하는 방식이 서로 다르기 때문입니다. IGV는 reference genome에 정렬된 sequencing read를 시각적으로 확인할 수 있도록 지원하는 반면, GATK HaplotypeCaller는 read filtering, local assembly 및 haplotype-based analysis를 통해 변이를 검출하고 allele support를 평가합니다.
이번 글에서는 IGV read count와 GATK AD의 차이를 이해하고, 이러한 불일치가 발생하는 주요 원인과 실제 분석에서 확인해야 할 사항을 살펴보겠습니다.
자주 묻는 질문 (FAQ)
Q1. IGV read 수와 GATK AD가 다르면 variant calling 오류인가요?
A. 반드시 그렇지는 않습니다. 이러한 차이가 반드시 variant calling 오류나 데이터 손상을 의미하는 것은 아닙니다. IGV와 GATK HaplotypeCaller는 read를 평가하고 집계하는 방식이 서로 다릅니다.
Q2. IGV 화면에서 센 read 수가 BAM 파일의 전체 read 수인가요?
A. 아닙니다. IGV에서 관찰되는 read count는 IGV의 표시 및 필터 설정에 영향을 받습니다. IGV에서 육안으로 확인한 read count가 실제 BAM 파일에 존재하는 모든 read의 수를 의미하지는 않습니다.
Q3. informative read란 무엇인가요?
A. 서로 다른 allele을 구분하는 데 충분한 정보를 제공하는 read를 의미합니다. REF와 ALT haplotype에 대한 likelihood가 거의 동일하다면 해당 read가 어느 allele을 지지하는지 명확하게 판단하기 어려우며, 이러한 read는 uninformative read로 간주되어 AD 계산에 포함되지 않을 수 있습니다.
Q4. AD의 합계는 항상 total depth(DP)와 일치하나요?
A. 일치하지 않을 수 있습니다. 이는 DP는 variant position 위 alignment되는 quality filter를 통과하는 모든 read로 계산되고 AD는 이 중 uninformative read를 제외한 informative read만 이용해 계산되기 때문입니다. 정확한 차이를 해석하려면 GATK 버전, VCF header, annotation 정의 및 분석 파라미터를 함께 확인해야 합니다.
Q5. bamout 파일로 원본 BAM과 read count를 직접 비교해도 되나요?
A. 주의가 필요합니다. HaplotypeCaller의 “–bam-output” 옵션을 활용하면 local assembly와 haplotype assignment 결과를 추가로 확인할 수 있지만, bamout 파일은 원본 BAM 파일을 단순히 복사한 것이 아니므로 원본 BAM과의 read count를 직접 비교할 때는 주의가 필요합니다.
1. IGV read count와 GATK Allelic Depth(AD)의 차이
IGV는 BAM 또는 CRAM 파일에 저장된 sequencing read를 reference genome의 특정 위치에 정렬된 형태로 시각화하는 도구입니다. 사용자는 IGV를 통해 특정 변이 위치에서 REF 및 ALT allele을 지지하는 read의 수, mapping quality, base quality, strand orientation 및 alignment pattern 등을 확인할 수 있습니다.
그러나 IGV에서 관찰되는 read count는 IGV의 표시 및 필터 설정에 영향을 받습니다. Mapping quality threshold, duplicate read 표시 여부, downsampling 등의 설정에 따라 화면에 나타나는 read의 수가 달라질 수 있습니다. 따라서 IGV에서 육안으로 확인한 read count가 실제 BAM 파일에 존재하는 모든 read의 수를 의미하지는 않습니다.
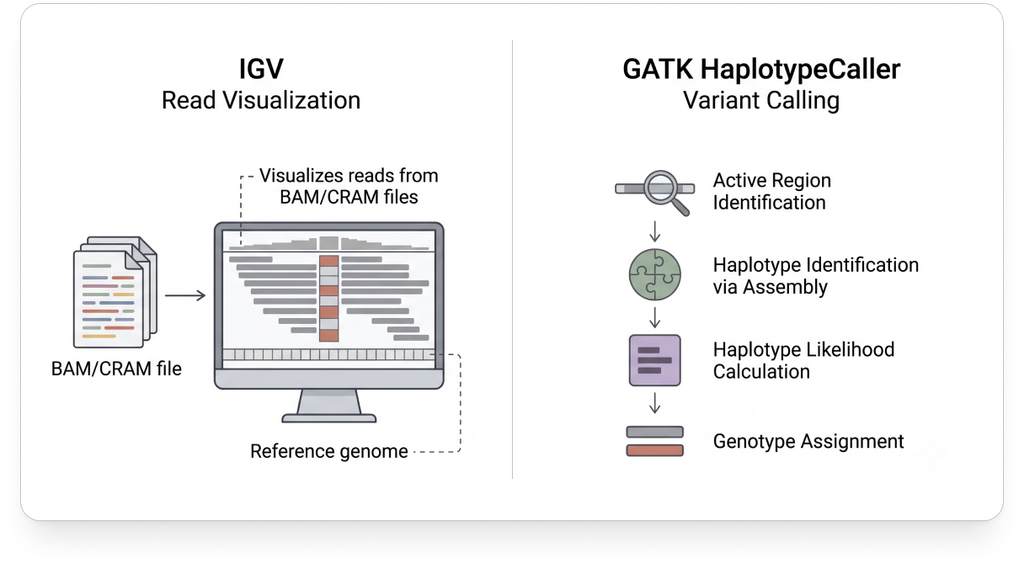
반면 GATK HaplotypeCaller는 특정 위치에 정렬된 REF 및 ALT base를 단순히 세는 방식으로 변이를 검출하지 않습니다. HaplotypeCaller는 변이 가능성이 있는 영역에서 local assembly를 수행하여 후보 haplotype을 구성하고, 각 sequencing read가 해당 haplotype에서 유래했을 가능성을 평가합니다. 이후 이러한 정보를 바탕으로 genotype likelihood를 계산하고 genotype을 결정합니다.
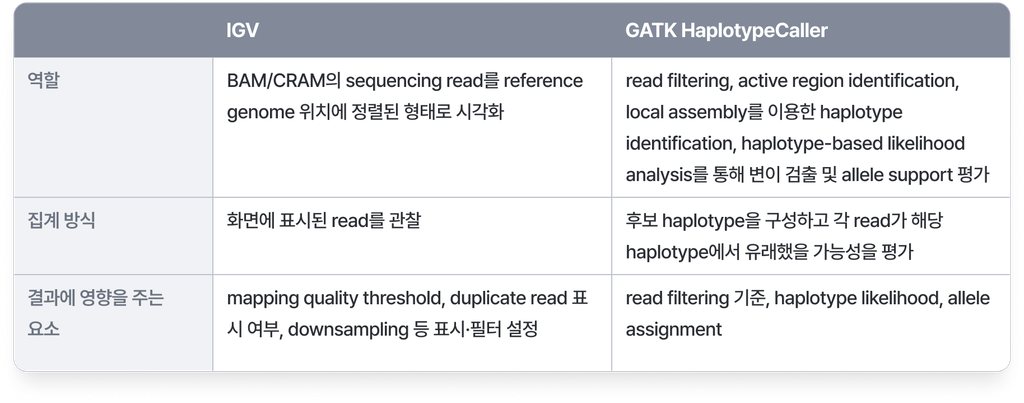
VCF의 FORMAT 필드에 기록되는 AD는 각 allele에 할당된 informative read의 depth를 나타냅니다. 여기서 informative read란 서로 다른 allele을 구분하는 데 충분한 정보를 제공하는 read를 의미합니다.
따라서 IGV에서 ALT allele을 포함하는 것으로 관찰되는 read라도 GATK의 분석 과정에서 제외되거나 특정 allele에 명확하게 할당되지 못하면 최종 AD에 포함되지 않을 수 있습니다.
2. Read filtering 기준에 따른 차이
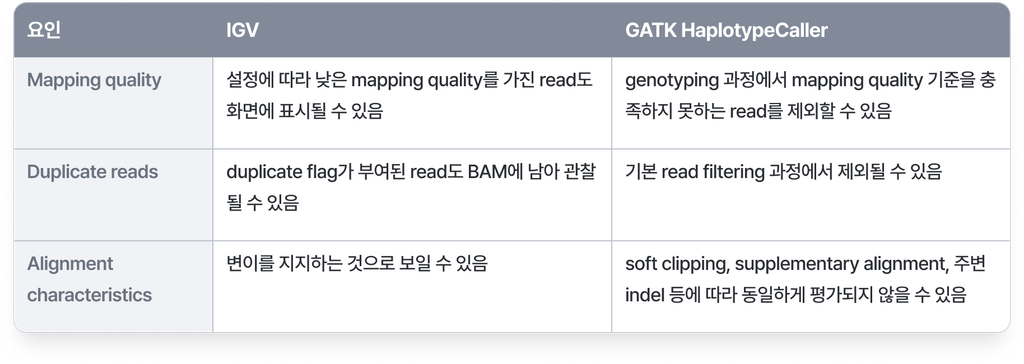
IGV read count와 GATK AD 사이에 차이가 발생하는 주요 원인 중 하나는 read filtering 기준의 차이입니다. GATK HaplotypeCaller는 분석 과정에서 특정 조건을 충족하지 못하는 read를 제외할 수 있습니다. 이러한 조건에는 mapping quality, duplicate status 및 alignment characteristics 등이 포함됩니다.
a. Mapping quality
Mapping quality(MAPQ)는 sequencing read가 reference genome의 특정 위치에 얼마나 신뢰성 있게 정렬되었는지를 나타내는 값입니다. Pseudogene, segmental duplication 또는 repetitive sequence가 존재하는 영역에서는 유사한 서열이 여러 genomic location에 존재하기 때문에 read가 특정 위치에 정확하게 정렬되었는지 판단하기 어려울 수 있습니다. 이러한 read는 낮은 mapping quality를 가질 수 있습니다.
IGV에서는 설정에 따라 낮은 mapping quality를 가진 read도 화면에 표시될 수 있지만, GATK HaplotypeCaller는 genotyping 과정에서 mapping quality 기준을 충족하지 못하는 read를 제외할 수 있습니다. 따라서 IGV에서 관찰되는 read가 모두 GATK AD에 반영되는 것은 아닙니다.
b. Duplicate reads
PCR amplification이나 sequencing 과정에서는 동일한 원본 DNA fragment에서 유래한 중복 read가 생성될 수 있습니다. 이러한 read는 일반적으로 duplicate marking 과정에서 식별되며, BAM 파일에 duplicate flag가 부여됩니다.
Duplicate로 표시된 read는 BAM 파일에 남아 IGV에서 관찰될 수 있지만, GATK HaplotypeCaller의 기본 read filtering 과정에서는 제외될 수 있습니다. 따라서 IGV에서 관찰되는 read의 수가 GATK가 실제 분석에 사용하는 read의 수보다 많을 수 있습니다.
다만 duplicate read의 처리 방식은 분석 파이프라인과 사용된 read filter 설정에 따라 달라질 수 있으므로, 정확한 원인을 확인하려면 해당 설정을 함께 검토해야 합니다.
c. Alignment characteristics
Read의 alignment characteristics 역시 allele support 평가에 영향을 줄 수 있습니다. 예를 들어, indel 주변 영역에서는 동일한 sequencing read라도 alignment 방식에 따라 변이의 위치나 표현이 달라질 수 있습니다. 특히 repetitive sequence가 존재하는 영역에서는 read가 REF 또는 ALT haplotype 중 어느 쪽을 지지하는지 명확하게 판단하기 어려울 수 있습니다.
Soft clipping, supplementary alignment 및 주변 indel 등의 특성도 read의 처리와 allele assignment에 영향을 미칠 수 있습니다. 이러한 이유로 IGV에서 특정 변이를 지지하는 것으로 보이는 read가 GATK의 분석 과정에서는 동일하게 평가되지 않을 수 있습니다.
3. Haplotype-based analysis와 allele assignment
GATK HaplotypeCaller의 중요한 특징은 haplotype-based variant calling을 수행한다는 점입니다.
일반적인 pileup 기반 접근 방식은 특정 genomic position에서 관찰되는 염기를 중심으로 변이를 평가합니다. 반면 HaplotypeCaller는 변이 후보 영역의 주변 서열 정보를 함께 고려하여 가능한 haplotype을 재구성합니다.
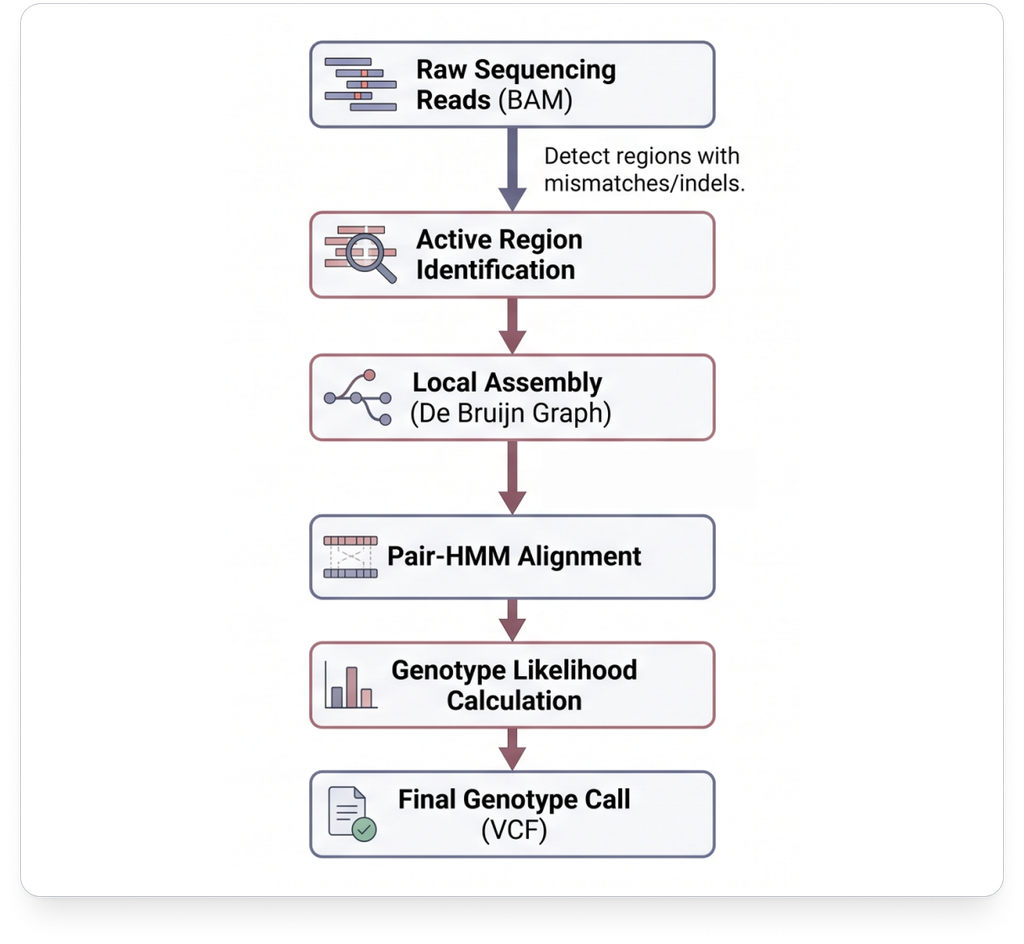
먼저 변이가 존재할 가능성이 있는 active region을 식별한 뒤, 해당 영역의 sequencing read를 이용하여 local assembly를 수행하여 이로 haplotype을 determination 합니다. 이후 Pair Hidden Markov Model(Pair-HMM) 등을 활용하여 각 read가 후보 haplotype에 부합할 likelihood를 계산합니다. 이러한 read-to-haplotype likelihood를 바탕으로 genotype likelihood를 계산하고 최종 genotype을 결정합니다.
이 과정에서는 특정 read가 변이 위치에서 ALT base를 포함하고 있다는 사실뿐 아니라, 주변 서열을 포함한 전체 read가 어떤 haplotype에 더 잘 부합하는지도 고려됩니다. 따라서 IGV에서 ALT base를 포함하는 것으로 관찰되는 read라도 ALT haplotype을 명확하게 지지하지 못한다면 AD에 반영되지 않을 수 있습니다.
이러한 차이는 특히 복잡한 indel, repetitive sequence 또는 여러 변이가 인접한 영역에서 중요하게 작용할 수 있습니다.
4. Informative read와 uninformative read
IGV read count와 GATK AD의 차이를 이해하는 데 중요한 개념은 informative read와 uninformative read의 구분 입니다.
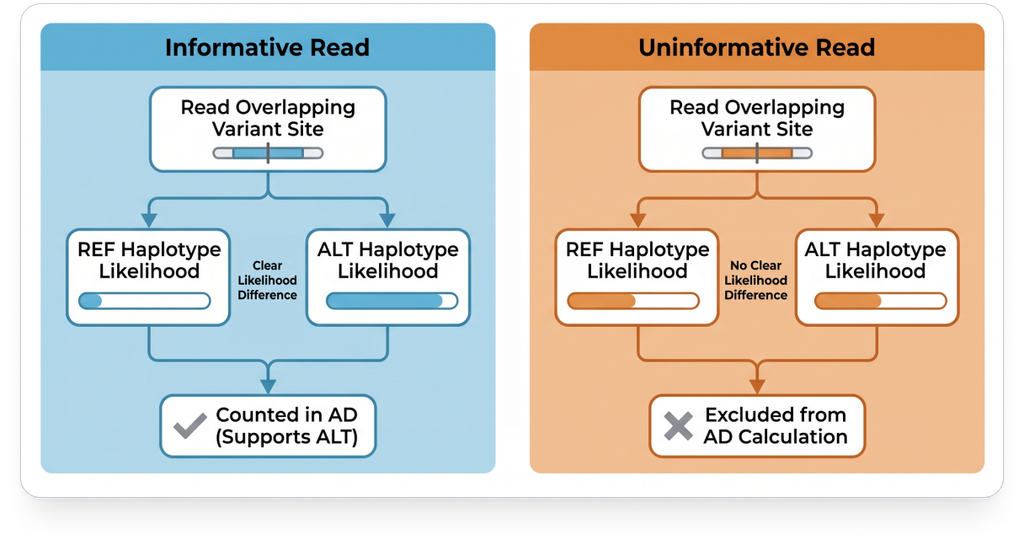
Informative read는 서로 다른 allele을 구분하는 데 충분한 정보를 제공하는 read입니다. 예를 들어, 특정 read가 ALT haplotype에 훨씬 높은 likelihood를 보이고 REF haplotype에는 낮은 likelihood를 보인다면, 해당 read는 ALT allele을 지지하는 informative read로 평가될 수 있습니다.
반면 REF와 ALT haplotype에 대한 likelihood가 거의 동일하다면, 해당 read가 어느 allele을 지지하는지 명확하게 판단하기 어렵습니다. 이러한 read는 uninformative read로 간주되어 AD 계산에 포함되지 않을 수 있습니다.
대표적인 예시는 repetitive sequence 영역입니다. Read가 반복서열의 일부만 포함하고 전체 반복 영역을 충분히 포괄하지 못하는 경우, 서로 다른 haplotype을 구분하기 어려울 수 있습니다. 이때 IGV에서는 특정 변이를 지지하는 read로 관찰되더라도 GATK의 allele assignment 과정에서는 informative read로 인정되지 않을 수 있습니다.
“즉, read가 특정 genomic position을 cover하고 있다는 사실과 해당 read가 특정 allele을 명확하게 지지한다는 것은 서로 다른 개념입니다.”
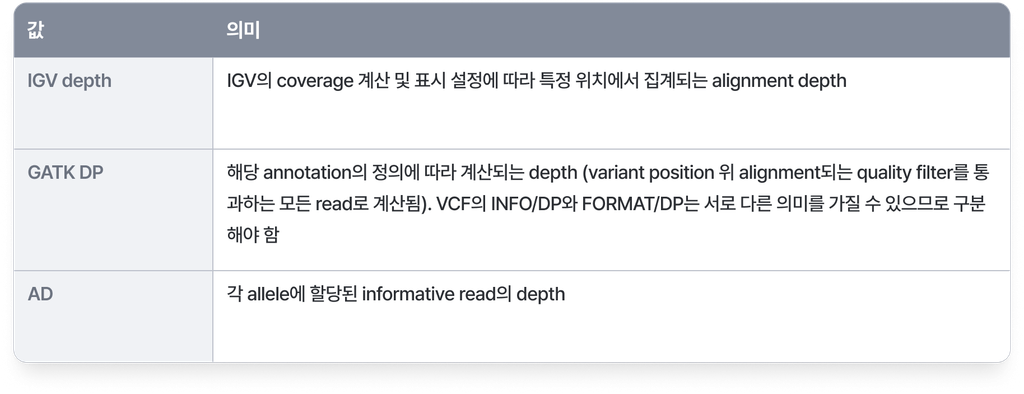
예를 들어 VCF에서 AD가 30,18로 기록되어 있다면 REF allele에 30개, ALT allele에 18개의 informative read가 할당되었다는 의미입니다.
그러나 AD의 합계가 항상 DP와 일치하는 것은 아닙니다. 그 이유는 DP는 variant position 위 alignment되는 quality filter를 통과하는 모든 read로 계산되고 AD는 이 중 uninformative read를 제외한 informative read만 이용해 계산되기 때문입니다. 정확한 차이를 해석하려면 GATK 버전, VCF header, annotation 정의 및 분석 파라미터를 함께 확인해야 합니다.
6. 실제 분석에서 차이가 발생했을 때 확인해야 할 사항
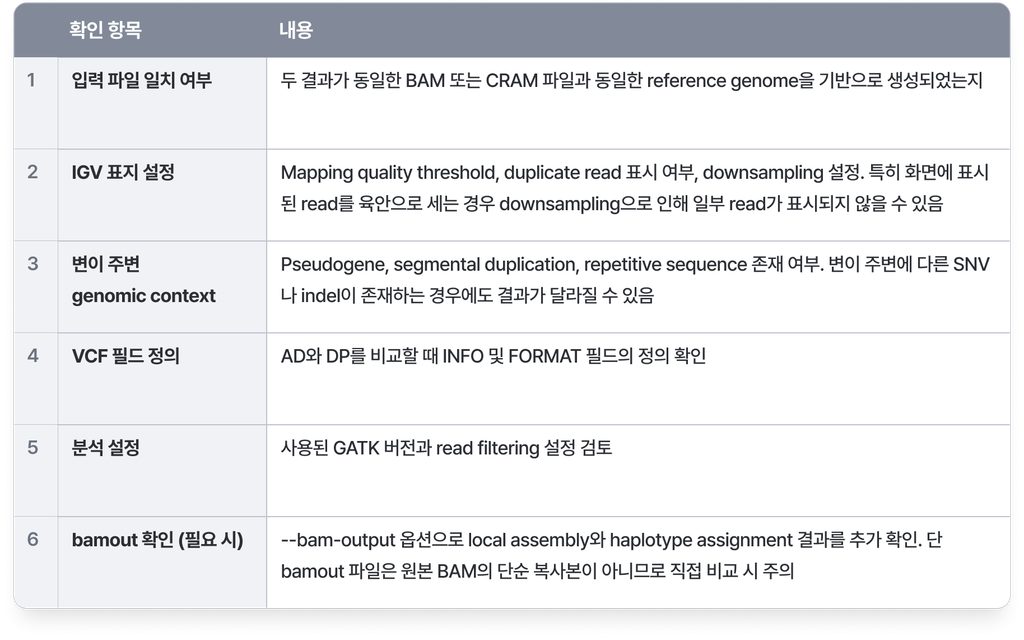
변이 주변에 다른 SNV나 indel이 존재하는 경우 HaplotypeCaller의 haplotype-based analysis가 단순한 position-based read counting과 다른 결과를 생성할 수 있습니다.
결론
IGV에서 관찰되는 read count와 GATK HaplotypeCaller의 Allelic Depth(AD)는 서로 다른 방식으로 산출되기 때문에 반드시 일치하지는 않습니다. IGV는 reference genome에 정렬된 sequencing read를 시각적으로 검토할 수 있도록 지원하는 반면, HaplotypeCaller는 read filtering, local assembly 및 haplotype-based likelihood 평가를 통해 allele support를 계산합니다.
특히 mapping quality, duplicate status, alignment characteristics 및 informative read 여부는 최종 AD 값에 영향을 줄 수 있습니다.
따라서 두 값 사이에 차이가 발생했을 때는 어느 한쪽의 결과가 잘못되었다고 판단하기보다, 각 값의 산출 방식과 분석 설정을 이해하고 read-level evidence를 종합적으로 검토하는 것이 중요합니다. IGV read count와 GATK AD의 차이는 반드시 분석 오류를 의미하지 않으며, read filtering과 allele assignment 과정에서 발생할 수 있는 차이로 이해해야 합니다.
하나의 변이를 판단할 때 VCF에 기록된 숫자만이 아니라 그 값이 어떻게 산출되었는지까지 함께 봐야 하는 이유가 여기에 있습니다. GEBRA는 이러한 변이 해석 과정을 지원하는 플랫폼으로, 무료로 직접 확인해 보실 수 있습니다.
희귀질환 변이 해석, 어떻게 하고 계신가요?
GEBRA의 판독 환경을 무료로 직접 확인해 보실 수 있습니다.
이 글의 시리즈
더보기
- [판독노트 #1] 3bCNV: WES와 패널 검출 기준
- [판독노트 #2] ROH와 UPD의 차이: 유전체 분석에서의 임상적 의미
- [판독노트 #3] 왜 IGV read count와 GATK AD 값이 다를까?